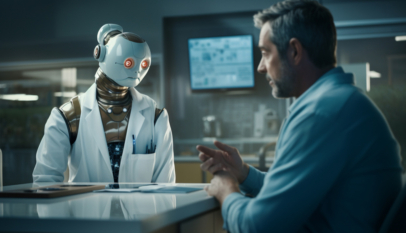
Čini li nas ChatGPT pametnijima ili nas samo navodi da s još većim uvjerenjem prihvaćamo pogrešne informacije?

Piše: dr. sc. Richard Z. Cheng
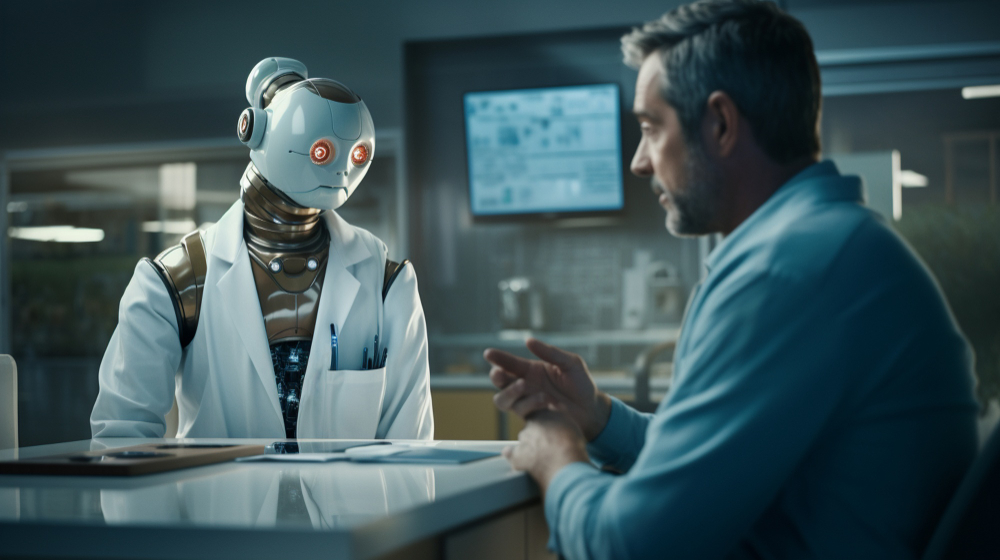
Još uvijek tražite od ChatGPT-ja, ili nekog drugog sustava umjetne inteligencije opće namjene, da vam kaže što biste trebali učiniti u vezi sa svojim zdravljem? Evo neugodnog pitanja: Što ako vam se prenose sustavni propusti suvremene medicine, a da toga uopće niste svjesni? Odgovor može stići u nekoliko sekundi. Isti se može pozivati na znanstvene studije i zvučati umirujuće autoritativno. No, ništa od toga ne znači da predstavlja cijelu istinu.
Umjetna inteligencija može učiniti da medicinski odgovor zvuči konačno i nedvosmisleno čak i kada je temeljno pitanje pogrešno postavljeno. Samouvjerenost nije istina; citat nije cjelovito uzročno objašnjenje. Ako znanstvena literatura, na koju se umjetna inteligencija oslanja, odražava selektivno financiranje, institucionalne navike, nedovoljno istražene intervencije ili neprikladne pretpostavke, odgovor koji iz toga proizlazi može prenijeti te slabosti u ordinaciju – brzinom stroja.
Je li riječ o doslovnom „ispiranju mozga”? Ne. Umjetna inteligencija ne mora nužno pokušavati bilo kime manipulirati. Rizik je suptilniji:
Uglađen odgovor može učiniti da naslijeđene pretpostavke djeluju kao utvrđene činjenice. Prepoznavanje tog rizika također ne znači da je suvremena medicina zavjera, da su farmaceutski proizvodi neučinkoviti ili da alternativni pristupi koji nisu dovoljno istraženi nužno djeluju. To znači da korisnici mogu usvojiti naslijeđenu pristranost upravo zato što odgovor djeluje sveobuhvatno, neutralno i utemeljeno na dokazima. Preporuku umjetne inteligencije treba preispitati, a ne štovati.
Naš preprint iz rujna 2026., Beyond Evidence Hierarchies: An Intervention-Aware, Contextual Systems Framework for Medical Artificial Intelligence (S onu stranu hijerarhija dokaza: kontekstualni sustavni okvir za medicinsku umjetnu inteligenciju koji uzima u obzir specifičnosti intervencija), bavi se temeljnim dijelom ovog izazova: Koji model medicine umjetna inteligencija uči – i je li taj model primjeren biološkom pitanju i pojedinom pacijentu?
1. Tko oblikuje medicinsko znanje iz kojeg umjetna inteligencija uči?
Prije nego što se zapitamo je li odgovor umjetne inteligencije utemeljen na dokazima, prvo se trebamo pitati sljedeće: Tko je imao priliku proizvesti te dokaze? Umjetna inteligencija opće namjene oslanja se na znanstvene publikacije, smjernice, udžbenike, klinička ispitivanja i druge materijale koje su proizveli ljudi. Ti izvori ne nastaju izvan društva. Istraživačke prioritete oblikuju dostupnost financiranja, institucionalni prioriteti, komercijalni poticaji, izdavačke prakse i potrebe javnog zdravstva. Takvi utjecaji mogu odrediti koja će pitanja dobiti pozornost, a koja će ostati nedovoljno istražena.
Novac ne narušava automatski vjerodostojnost rezultata. Ipak, financijski poticaji mogu utjecati na to koja se pitanja uopće postavljaju. Intervencija koja obećava komercijalni uspjeh može privući znatna ulaganja i velika klinička ispitivanja. Nasuprot tome, preventivne strategije, prehrana, promjene životnog stila ili kombinacije intervencija koje se ne mogu patentirati mogu se suočiti s drukčijim financijskim poticajima i metodološkim izazovima. Ta je neravnoteža razlog za istraživanje – a ne dokaz da su farmaceutske studije nepouzdane ili da su intervencije s nedostatnim financiranjem učinkovite.
Broj znanstvenih radova nije referendum o istini. Više publikacija ne znači automatski manje pristranosti. Manje publikacija ne znači automatski da nema koristi. No manja baza dokaza također se ne može smatrati pozitivnim dokazom učinkovitosti neke intervencije.
Nepostojanje dokaza, dokazi o izostanku klinički značajnog učinka i dokazi dobiveni ispitivanjem koje nije bilo primjereno postavljenom pitanju različite su kategorije. Medicinska umjetna inteligencija mora prepoznavati te razlike. Ondje gdje je to relevantno, trebala bi prepoznati sukobe interesa i ograničenja dokaza, bez pretpostavljanja loše namjere ili donošenja zaključaka koje podaci ne podupiru.
2. Više podataka može značiti veći autoritet – ali ne nužno i više istine
Evo paradoksa: što medicinska umjetna inteligencija postaje tečnija u izražavanju, to je teže uočiti njezine sustavne propuste. Umjetna inteligencija može naslijediti sustavne pogreške medicinske literature i njezina pojmovnog rječnika. Učenje na temelju sve većeg broja publikacija ne ispravlja automatski nedostatke u financiranju istraživanja, uzročnim modelima ili zastupljenosti različitih skupina pacijenata. Tečan odgovor može svesti neizvjesnost na minimum, izostaviti zanemareni mehanizam ili preporuku koja vrijedi za prosječnog pripadnika populacije prikazati kao da je nedvojbeno primjenjiva na pojedinca.
To nije isto što i tvrdnja da umjetna inteligencija ne može ispraviti pristranosti. Pažljivo pronalaženje relevantnih izvora, usporedna procjena dokaza, neovisno vrednovanje i transparentno zaključivanje mogu pomoći. No te zaštitne mjere moraju biti namjerno osmišljene i provjerene. Povećavanje modela nije zamjena za preispitivanje njegovih pretpostavki.
Temeljna je zabrinutost jednostavna: umjetna inteligencija uvježbana unutar nepotpunog okvira može postati iznimno dobra u primjeni nepotpunog modela medicine. Rješenje zahtijeva bolji model medicinskog zaključivanja, a ne samo brži sustav za generiranje odgovora.
3. Dijagnoza i uzročno objašnjenje nisu isto: primjer dijabetesa tipa 2
Razmotrimo razliku između imenovanja bolesti i razumijevanja pojedinca. Dijabetes tipa 2 koristan je primjer. Dijagnozom se utvrđuje klinički važno stanje. Lijekovi utemeljeni na dokazima mogu sniziti razinu glukoze i kod odgovarajućih pacijenata smanjiti rizik od važnih komplikacija. Ipak, samo imenovanje bolesti ne objašnjava zašto se razvila upravo kod tog pacijenta.
Liječnik će možda trebati istražiti inzulinsku rezistenciju, visceralnu pretilost, prehrambene obrasce, energetsku ravnotežu, tjelesnu aktivnost i skeletne mišiće, san, lijekove, genetiku, stres i druge relevantne čimbenike. Njihova relativna važnost razlikuje se među pacijentima. Neće svaki predloženi čimbenik u svakom pojedinom slučaju biti uzročno povezan s bolešću ili podložan promjeni.
Oznaka bolesti nužna je za mnoge svrhe. No ona nije cjelovit model uzročnosti bolesti. Umjetna inteligencija koja samo povezuje „dijabetes tipa 2” s kliničkom smjernicom može previdjeti klinički važne obrasce razvoja bolesti i procese na koje se može utjecati. S druge strane, zaključivanje usmjereno na temeljne uzroke nikada ne smije postati izgovor za prekidanje provjerenog liječenja ili zamjenu dokazane koristi uvjerljivim, ali nedokazanim mehanizmom.
(Članak u cijelosti pročitajte na poveznici ispod.)
(Izvor: orthomolecular.org; 12. listopada 2026.)
DAR S NEBA: Zahvaljujući vodi dobivenoj munjama, jagode više nikada neće biti pljesnive
Piše: Michael Persson U čeličnom ormariću u velikom pogonu tvrtke VitalFluid iza malog pro…
Čini li nas ChatGPT pametnijima ili nas samo navodi da s još većim uvjerenjem prihvaćamo pogrešne informacije?
Piše: dr. sc. Richard Z. Cheng Još uvijek tražite od ChatGPT-ja, ili nekog drugog …

David Icke
Listopad/Studeni 2026.